Technik
Technische KI-Sichtbarkeit: Warum KI-Crawler deine Website nicht verstehen
Deine IT hat GPTBot blockiert und du wunderst dich, warum ChatGPT dich nicht kennt. Hier sind die technischen Grundlagen, die darüber entscheiden, ob KI deine Website lesen, verstehen und zitieren kann.
- Autor
- Vadim Shchepin, AI SEO Specialist
- Veröffentlicht
- Aktualisiert
Inhalt, 13 Abschnitte
1.Das Problem: Deine Website spricht kein KI
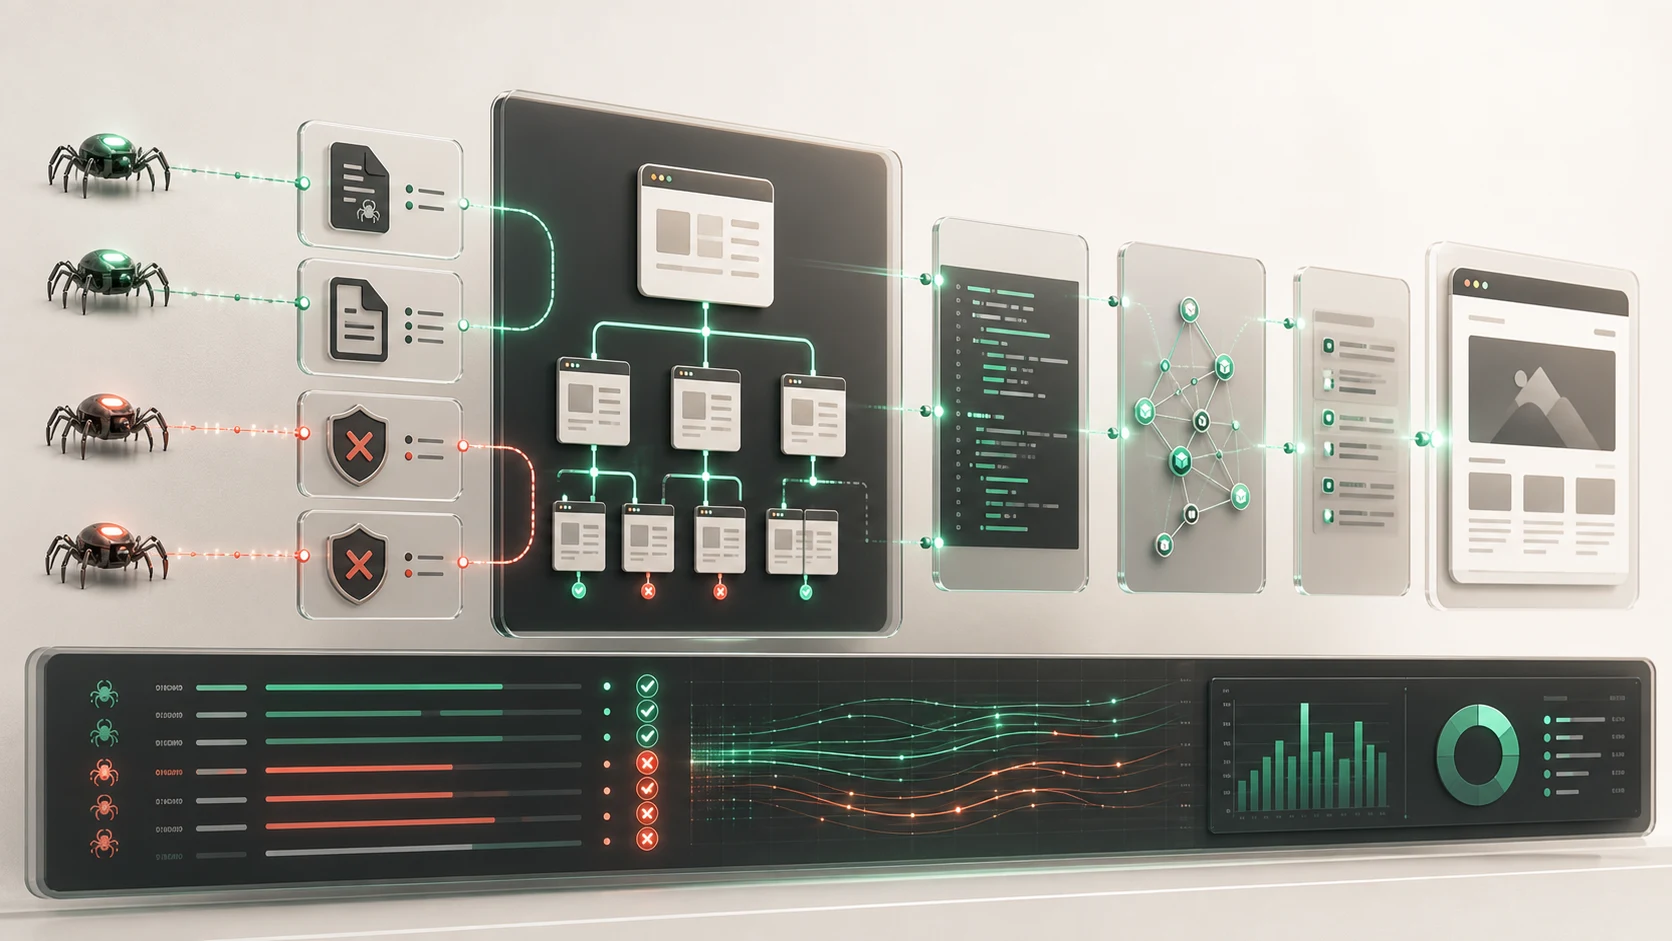
KI-Crawler lesen Websites fundamental anders als der Googlebot. Sie führen kein JavaScript aus, sie rendern keine CSS-Layouts, sie sehen keine Bilder. Was sie sehen: rohes HTML, strukturierte Daten und Textinhalt. Stimmt das nicht, existierst du für sie nicht.
Seit dem 1. Juli 2025 blockiert Cloudflare KI-Crawler bei neuen Domains standardmäßig. Wer nie eine Entscheidung getroffen hat, hat sie damit ausgesperrt.
Dein CMS rendert JavaScript. Die meisten KI-Crawler können kein JavaScript. Das ist der ganze Konflikt in zwei Sätzen.
Aus berechtigter Angst vor Datenklau haben viele Unternehmen 2024 alle KI-Crawler ausgesperrt. Jetzt stellen sie fest, dass sie sich aus dem Zukunftsmarkt zensiert haben.
Viele Security-Plugins und WAFs blockieren GPTBot, PerplexityBot und ClaudeBot pauschal, oft schon in der Standardkonfiguration. Dein IT-Team hat vermutlich keine böse Absicht, aber das Ergebnis ist dasselbe: deine Website ist für KI unsichtbar. Was KI-Sichtbarkeit inhaltlich bedeutet, steht im Grundlagen-Guide. Diese Seite behandelt nur die Technik darunter.
Die Reihenfolge der Diagnose ist immer dieselbe: Kommt der Bot überhaupt an, im Server-Log nachsehen. Bekommt er HTML mit Text, in den Quelltext schauen statt in den Inspector. Versteht er die Entität, Schema prüfen. Findet er eine abgrenzbare Passage, Struktur prüfen. Wer bei Schritt vier anfängt, obwohl Schritt eins fehlschlägt, optimiert für ein System, das die Seite nie gesehen hat.
| Die vier häufigsten technischen Fehler | Ursache | Folge für den KI-Crawler |
|---|---|---|
| robots.txt blockiert KI-Bots | Security-Plugins setzen pauschal Disallow für alle unbekannten User-Agents. | Der Abruf findet nie statt. Keine Daten, keine Zitate. |
| JavaScript-Only-Rendering | SPAs ohne SSR liefern KI-Crawlern eine leere HTML-Hülle. | Abruf erfolgreich, Inhalt leer. Der Crawler sieht ein Grundgerüst. |
| Fehlende strukturierte Daten | Ohne Schema.org kann KI dein Unternehmen nicht als Entität einordnen. | Text ohne Einordnung. Name, Ort und Leistung bleiben Vermutung. |
| Keine semantische HTML-Struktur | Div-Suppe statt sauberer Heading-Hierarchie macht Inhalte unextrahierbar. | Keine abgrenzbare Passage, die zitiert werden könnte. |
2.KI-Crawler: Wer ist wer?
Sechs Crawler entscheiden über deine KI-Sichtbarkeit. Blockierst du einen, bist du auf der jeweiligen Plattform unsichtbar.
User-Agents lassen sich fälschen, und ein Teil der angeblichen KI-Zugriffe im Log kommt von Scrapern, die sich als GPTBot ausgeben. Die Betreiber veröffentlichen deshalb ihre IP-Bereiche, und ein Reverse-DNS-Check auf die abrufende IP trennt echte Crawler von Nachahmern. Das gehört gemacht, bevor du aus Log-Zahlen ableitest, wie oft KI-Systeme dich wirklich lesen.
| Crawler | Zweck | Betreiber | User-Agent | robots.txt-Direktive |
|---|---|---|---|---|
| GPTBot | Trainingsdaten für GPT-Modelle | OpenAI | GPTBot/1.0 | User-agent: GPTBot |
| OAI-SearchBot | Live-Suche in ChatGPT (SearchGPT) | OpenAI | OAI-SearchBot/1.0 | User-agent: OAI-SearchBot |
| PerplexityBot | Echtzeit-Index für Perplexity-Antworten | Perplexity | PerplexityBot | User-agent: PerplexityBot |
| ClaudeBot | Trainingsdaten und Web-Suche für Claude | Anthropic | ClaudeBot/1.0 | User-agent: ClaudeBot |
| Googlebot | Indexierung und AI Overviews | Googlebot/2.1 | User-agent: Googlebot | |
| Bingbot | Indexierung, speist ChatGPT und Perplexity | Microsoft | bingbot/2.0 | User-agent: Bingbot |
Bingbot ist der stille Multiplikator: Er speist sowohl ChatGPT als auch Perplexity mit Daten. Blockierst du Bingbot, verlierst du gleich zwei Plattformen.
3.robots.txt für KI-Sichtbarkeit
Die robots.txt ist die erste Tür, die KI-Crawler öffnen. Ist sie zu, gehen sie weiter. Keine zweite Chance.
Viele Unternehmen haben nach dem KI-Hype 2024 pauschal alle KI-Bots blockiert. Das war nachvollziehbar, aber strategisch ein Fehler. Du kannst selektiv erlauben, was du öffentlich machen willst, und den Rest schützen.
Wichtig ist die Reihenfolge der Prüfung: erst robots.txt, dann WAF, dann CDN. Eine erlaubende robots.txt hilft nichts, wenn eine Firewall-Regel oder ein Bot-Schutz denselben User-Agent zwei Schichten tiefer mit 403 abweist. Der Crawler meldet dir das nicht, im Server-Log steht es trotzdem.
Zwei Direktiven werden regelmäßig übersehen, weil sie nicht in der robots.txt stehen, sondern im Meta-Robots-Tag: nosnippet und max-snippet. Google verwendet für AI Overviews nur Text, der auch als Snippet erlaubt ist. Wer nosnippet setzt oder max-snippet klein hält, bleibt indexiert und verschwindet trotzdem aus den KI-Antworten. Das ist der leiseste Weg, sich selbst unsichtbar zu machen.
robots.txt, KI-optimiert
# Alle KI-Crawler explizit erlauben.
# Mehrere User-agent-Zeilen vor einem Regelblock sind erlaubt
# und halten die Regeln für alle Bots identisch.
User-agent: GPTBot
User-agent: OAI-SearchBot
User-agent: PerplexityBot
User-agent: ClaudeBot
User-agent: Googlebot
User-agent: Bingbot
Allow: /
Disallow: /intern/
Disallow: /api/

# Standard-Crawler
User-agent: *
Allow: /
Disallow: /intern/
Disallow: /api/

Sitemap: https://example.com/sitemap.xml
| Bereich | Was du NICHT blockieren solltest | Was du blockieren kannst |
|---|---|---|
| Inhalte | Service-Seiten, Case Studies, Blog-Artikel und FAQ-Seiten | Proprietäre Inhalte hinter Login-Bereichen |
| Entität | Impressum und Kontaktseite, das sind deine Entity-Signale | Interne Dashboards, Admin-Bereiche und API-Endpunkte |
| Technik | Strukturierte Daten und Schema.org-Markup | Staging-Umgebungen und Test-Seiten |
Die robots.txt ist nicht die einzige Tür
4.llms.txt: Der neue Standard für LLM-Sichtbarkeit
llms.txt ist ein Vorschlag für eine standardisierte Datei im Root-Verzeichnis deiner Website, die LLMs eine kompakte, maschinenlesbare Zusammenfassung deines Unternehmens liefert. Ähnlich wie robots.txt für Crawler oder humans.txt für Menschen.
Der Unterschied: robots.txt sagt Crawlern, was sie dürfen. llms.txt sagt LLMs, wer du bist und was du anbietest. Es ist dein Elevator Pitch für Maschinen.
Erwartungswert für 2026, damit du nicht enttäuscht wirst: Google hat für die eigenen KI-Funktionen ausdrücklich klargestellt, dass llms.txt nicht ausgewertet wird (mehr dazu im Begriffsvergleich). Für ChatGPT, Claude und Perplexity ist die Datei ein zusätzlicher, sehr leicht abrufbarer Einstiegspunkt. Eine Stunde Aufwand, überschaubarer Nutzen, kein Ersatz für saubere Seiten.
Was llms.txt nicht kann: Sie verschafft dir keine Zitate, wenn die verlinkten Seiten dünn sind. Sie ist ein Inhaltsverzeichnis, kein Inhalt. Ihr Wert liegt darin, dass ein Modell in einem einzigen Abruf versteht, was du anbietest, statt es aus einer Navigation zu rekonstruieren. Wer sie mit Marketingtext füllt, verschenkt genau diesen Vorteil.
llms.txt, Beispiel
# llms.txt - [Firmenname]

## Unternehmen
[Firmenname] ist ein [Branche]-Unternehmen in [Stadt].
Wir bieten [Kernleistungen].

## Leistungen
- [Leistung 1]: [Kurzbeschreibung]
- [Leistung 2]: [Kurzbeschreibung]

## Zielgruppe
[Wer sind eure Kunden? Branche, Größe, Region]

## Kontakt
- Website: https://example.com
- E-Mail: kontakt@example.com
- Standort: [Stadt, Region]

## Wichtige Seiten
- /leistungen - Übersicht aller Leistungen
- /ueber-uns - Über das Unternehmen
- /blog - Fachartikel und Insights
- /kontakt - Kontaktformular
Implementierung: Datei im Root anlegen
Erstelle eine Datei llms.txt im Root deiner Domain, also unter https://example.com/llms.txt. Kein Unterverzeichnis, kein anderer Dateiname, Content-Type text/plain.
Zusammenfassung in Markdown schreiben
Schreibe eine klare, strukturierte Zusammenfassung deines Unternehmens in Markdown. Überschriften, kurze Sätze, Zahlen statt Adjektive. Marketingsprache wird hier nicht belohnt, weil niemand sie liest, der sie glauben könnte.
Datei aktuell halten
Halte die Datei aktuell, veraltete Informationen schaden mehr als keine. Ein falscher Preis oder ein alter Firmenname wandert von hier direkt in eine Antwort. Setz dir einen festen Termin pro Quartal.
Wichtigste Seiten mit Kontext verlinken
Verlinke die wichtigsten Seiten deiner Website und schreibe hinter jeden Link einen Satz, was dort steht. Der Satz ist der eigentliche Wert, nicht die URL.
5.Schema.org Markup für LLMs
Strukturierte Daten sind für KI-Systeme das, was ein Organigramm für einen neuen Mitarbeiter ist: Kontext, Einordnung, Beziehungen. Ohne Schema.org bist du für LLMs ein unbekannter Textblock.
Zwei Details entscheiden, ob aus Markup eine Entität wird. Erstens dieselben Angaben zu Name, Adresse und Telefonnummer auf jeder Seite, im Impressum und in externen Verzeichnissen, ohne Abweichung. Zweitens verknüpfte Objekte statt isolierter Schnipsel, also eine @id für die Organisation, auf die Article, Product und FAQPage verweisen. Ein Modell, das drei leicht verschiedene Firmennamen findet, nennt am Ende keinen davon.
JSON-LD im head: LocalBusiness und FAQPage
<script type="application/ld+json">
{
  "@context": "https://schema.org",
  "@type": "LocalBusiness",
  "name": "Firmenname",
  "description": "Kurzbeschreibung der Leistungen",
  "url": "https://example.com",
  "telephone": "+49-40-1234567",
  "address": {
    "@type": "PostalAddress",
    "streetAddress": "Musterstraße 1",
    "addressLocality": "Hamburg",
    "postalCode": "20095",
    "addressCountry": "DE"
  },
  "areaServed": "Hamburg",
  "sameAs": [
    "https://linkedin.com/company/firmenname",
    "https://instagram.com/firmenname"
  ]
}
</script>

<script type="application/ld+json">
{
  "@context": "https://schema.org",
  "@type": "FAQPage",
  "mainEntity": [
    {
      "@type": "Question",
      "name": "Was kostet Leistung X?",
      "acceptedAnswer": {
        "@type": "Answer",
        "text": "Leistung X kostet ab 500 Euro..."
      }
    }
  ]
}
</script>Organization / LocalBusiness
Die Entitäts-Identität: Wer bist du? Ohne dieses Schema kann KI dich nicht als Entität erkennen. Name, Adresse und sameAs-Profile verhindern die Verwechslung mit einer ähnlich benannten Firma.
FAQPage
Direkte Antworten auf Nutzerfragen. Hochrelevant für KI, weil LLMs FAQ-Strukturen bevorzugt extrahieren. Frage und Antwort stehen darin schon getrennt, das Modell muss nichts zerlegen.
HowTo
Schritt-für-Schritt-Anleitungen. Ideal für prozessbasierte Inhalte, die KI als Handlungsanweisung weitergeben kann. Jeder Schritt braucht ein eigenes name-Feld, sonst bleibt es ein Textblock mit Auszeichnung.
Article mit Author
E-E-A-T-Signal: Wer hat den Inhalt geschrieben? Echte Autoren mit Expertise werden von KI bevorzugt zitiert. Der Author verweist idealerweise auf eine Personenseite, die es wirklich gibt.
Product
Für kommerzielle Inhalte: Preis, Verfügbarkeit, Bewertungen. Wird von KI für Kaufempfehlungen herangezogen. Ausgedachte Bewertungen sind hier riskanter als gar keine.
Schema.org liefert KI den Kontext. Ohne Kontext bist du ein anonymer Textblock unter Millionen.
6.Semantisches HTML: Warum Struktur alles ist
KI-Crawler sehen kein Design, sie sehen DOM-Struktur. Ein perfekt gestalteter Abschnitt in einem div ohne semantische Bedeutung ist für LLMs unsichtbar. Ein klar strukturiertes article mit sauberer Heading-Hierarchie wird extrahiert und zitiert.
Ein Prinzip trägt die vier Regeln: eine Frage pro Abschnitt, und der Abschnitt muss ohne die Seite um ihn herum verständlich bleiben. Zitiert wird nie die Seite, zitiert wird der Absatz. Steht darin "wie oben beschrieben" oder "das Tool", ist die Passage aus dem Zusammenhang gerissen wertlos und fällt aus der Antwort heraus.
Semantisches HTML, falsch und richtig
<!-- FALSCH: Div-Suppe -->
<div class="section">
  <div class="title">Unsere Leistungen</div>
  <div class="text">Wir bieten X, Y und Z an.</div>
</div>

<!-- RICHTIG: Semantisches HTML -->
<article>
  <h2>Unsere Leistungen</h2>
  <p>Wir bieten X, Y und Z an. [Antwort zuerst]</p>
  <ul>
    <li>Leistung X: Beschreibung</li>
    <li>Leistung Y: Beschreibung</li>
    <li>Leistung Z: Beschreibung</li>
  </ul>
</article>| Die vier Regeln für KI-lesbares HTML | Konkret | Warum LLMs das brauchen |
|---|---|---|
| Heading-Hierarchie | Genau ein H1 pro Seite, H2 für Hauptabschnitte, H3 für Unterabschnitte, keine Sprünge von H1 auf H4. | Die Heading-Struktur ist das Werkzeug, mit dem Inhalte thematisch gruppiert werden. |
| Answer-first-Absätze, 40 bis 60 Wörter | Der erste Satz beantwortet die Frage, danach kommt der Kontext. | Extrahiert werden bevorzugt die ersten 40 bis 60 Wörter eines Abschnitts. Steht die Antwort im dritten Satz, wird sie abgeschnitten. |
| Tabellen für Vergleichsdaten | table, thead und tbody mit sauberen Headern, nicht Spalten aus Divs. | Strukturierte Vergleiche werden bevorzugt extrahiert, weil Zeile und Spalte die Bedeutung schon tragen. |
| Listen für scannbare Inhalte | Geordnete Listen (ol) für Schrittfolgen, ungeordnete (ul) für Aufzählungen. | Listenpunkte werden als eigenständige Informationseinheiten erkannt, ideal für Checklisten. |
7.Core Web Vitals & Page Speed für KI
KI-Crawler haben Timeout-Limits. Antwortet deine Seite zu langsam, bricht der Crawler ab und indexiert nichts. Schnelle Seiten werden häufiger gecrawlt und vollständiger indexiert.
TTFB ist die kritischste Metrik für KI-Crawler. Wenn dein Server länger als 800ms braucht, um zu antworten, wird der Crawl-Versuch möglicherweise abgebrochen. CDNs, Edge-Caching und Server-Side Rendering sind deine Werkzeuge.
Der zweite Effekt wird oft übersehen: Schnelle Seiten werden häufiger neu abgeholt. Bei Perplexity, das zum Zeitpunkt der Frage abruft, entscheidet die Antwortzeit mit darüber, ob die aktuelle Fassung deiner Seite in die Antwort kommt oder die zuletzt indexierte. Serverseitiges Caching ist damit kein reines Performance-Thema, sondern Teil der Aktualität deiner Sichtbarkeit.
| Metrik | Zielwert | Relevanz für KI |
|---|---|---|
| LCP (Largest Contentful Paint) | bis 2,5 s | Crawler brechen bei langsamer Antwort ab |
| CLS (Cumulative Layout Shift) | bis 0,1 | Indirekt: Google-Ranking beeinflusst KI-Datenquellen |
| INP (Interaction to Next Paint) | bis 200 ms | Indirekt: Nutzererfahrung beeinflusst Engagement-Signale |
| TTFB (Time to First Byte) | bis 800 ms | Direkt: Crawler-Timeout-Schwelle |
8.JavaScript Rendering: Das unsichtbare Problem
Die meisten KI-Crawler führen kein JavaScript aus. Ist deine Website eine Single-Page-Application, die Content erst nach dem Laden per JavaScript rendert, sehen KI-Crawler eine leere Seite. Buchstäblich.
Googlebot kann JavaScript rendern, mit Verzögerung. GPTBot, PerplexityBot und ClaudeBot können es nicht. Das heißt: Du kannst bei Google auf Platz 1 ranken und für ChatGPT gleichzeitig unsichtbar sein.
Der Test dauert zehn Sekunden. Lade die Seite mit deaktiviertem JavaScript, oder schau in den Quelltext statt in den Inspector. Was dort an Text steht, ist alles, was ein KI-Crawler von dir hat.
| Rendering | KI-Crawler sehen | Empfehlung |
|---|---|---|
| SSR (Server-Side Rendering) | Vollständigen Content | Empfohlen |
| SSG (Static Site Generation) | Vollständigen Content | Empfohlen |
| CSR (Client-Side Rendering) | Leere HTML-Hülle | Vermeiden |
| ISR (Incremental Static Regen.) | Vollständigen Content | Empfohlen |
Die Mischform ist der häufigere Fall
9.Frameworks mit SSR/SSG-Support
Die Framework-Wahl entscheidet die Rendering-Frage, bevor sie zum Problem wird. Alle fünf hier liefern serverseitiges HTML, nur die Stolperstellen unterscheiden sich.
Der Test gehört in den Deploy, nicht in ein Quartalsritual. Ein Skript, das nach jedem Release den Quelltext einer Kernseite abruft und nach drei Pflichtsätzen sucht, findet ein Rendering-Problem am selben Tag. Ohne diesen Schritt fällt es beim nächsten Framework-Update auf, im schlechteren Fall Monate später über fehlende Zitate.
| Framework | Was es liefert | Worauf du achten musst |
|---|---|---|
| Next.js (React) | SSR, SSG, ISR out of the box | Client-Komponenten liefern kein HTML. Inhalt gehört in Server-Komponenten. |
| Nuxt (Vue) | SSR und SSG | Der Standardmodus rendert serverseitig. Den reinen SPA-Modus nicht aktivieren. |
| Astro | Static-first, partial hydration | Islands bleiben im HTML leer. Text gehört nicht in ein Island. |
| SvelteKit | SSR und SSG | Prerender-Option pro Route setzen, sonst bleibt es beim Client-Rendering. |
| WordPress | nativ serverseitig gerendert | Achtung bei Headless-Setups: dann entscheidet das Frontend, nicht WordPress. |
10.Technische Checkliste: Ist deine Website KI-ready?
Fünfzehn Punkte, jeder in unter einer Stunde prüfbar. Die ersten drei entscheiden, ob die übrigen zwölf überhaupt eine Wirkung haben.
Arbeite die Liste von oben nach unten ab, nicht nach Aufwand sortiert. Punkt eins bis drei sind Zugang und Identität, sie entscheiden über die Wirkung aller weiteren. Punkt vier bis zehn sind Extraktion, dort entstehen die Zitate. Der Rest ist Hygiene: richtet keinen Schaden an, bewegt allein aber auch nichts.
| Prüfpunkt | Wo prüfen | Womit prüfen |
|---|---|---|
| robots.txt erlaubt GPTBot, OAI-SearchBot, PerplexityBot, ClaudeBot | deine-domain.de/robots.txt | Browser, danach curl mit dem Bot-User-Agent gegen eine Inhaltsseite |
| llms.txt im Root-Verzeichnis mit aktuellen Unternehmensdaten | deine-domain.de/llms.txt | Browser, Inhalt gegen die Website gegenlesen |
| Schema.org LocalBusiness/Organization auf allen Seiten | JSON-LD im head, Quelltext | Rich Results Test oder ein Schema-Validator |
| FAQPage-Schema auf FAQ-Seiten | Quelltext der FAQ-Seiten | Rich Results Test |
| Article-Schema mit Author auf Blog-/Wissensseiten | Quelltext der Artikel | Rich Results Test, danach die Author-URL anklicken |
| Saubere Heading-Hierarchie (H1 > H2 > H3, keine Sprünge) | gerenderte Seite | Heading-Outline im Accessibility-Baum des Browsers |
| Answer-first-Absätze: Kernaussage in den ersten 40-60 Wörtern | jeder einzelne Abschnitt | ersten Satz allein lesen, beantwortet er die Frage? |
| Server-Side Rendering oder Static Site Generation aktiv | Quelltext, nicht Inspector | JavaScript deaktivieren, ist der Text noch da? |
| TTFB unter 800ms, LCP unter 2,5s | Netzwerk-Tab und Felddaten | PageSpeed Insights, Core-Web-Vitals-Bericht |
| Sitemap.xml aktuell und in robots.txt verlinkt | robots.txt und /sitemap.xml | letzte lastmod-Daten auf Plausibilität prüfen |
| Keine WAF/Security-Plugin-Blockade für KI-User-Agents | Firewall- und CDN-Logs | curl mit Bot-User-Agent, auf den Statuscode achten |
| Canonical Tags korrekt gesetzt | head jeder Seite | zeigt der Canonical auf die Seite selbst? |
| Hreflang-Tags bei mehrsprachigen Websites | head aller Sprachversionen | Rückverweis jeder Variante prüfen |
| Open Graph und Twitter Card Markup vorhanden | head | Link in einem Messenger einfügen, Vorschau ansehen |
| Interne Verlinkung mit beschreibenden Ankertexten | Fließtext der Seiten | Ankertexte auflisten, nach "hier klicken" suchen |
Häufig gestellte Fragen
Welche KI-Crawler muss ich in robots.txt erlauben?
Was ist llms.txt und brauche ich das?
Reicht Schema.org Markup allein für KI-Sichtbarkeit?
Können JavaScript-Websites in KI sichtbar sein?
Wie teste ich, ob KI-Crawler meine Website lesen können?
Wie schnell wirken technische Optimierungen auf KI-Sichtbarkeit?
Quellen
- [1]OpenAI, Stand August 2026: GPTBot Dokumentation, User-Agent-Spezifikation und robots.txt-Richtlinien für GPTBot und OAI-SearchBot. Quelle
- [2]Anthropic, Stand August 2026: ClaudeBot Web Crawling, technische Dokumentation zum ClaudeBot-Crawler und Opt-out-Möglichkeiten.
- [3]llmstxt.org, Stand August 2026: llms.txt Spezifikation, Vorschlag für einen Standard zur maschinenlesbaren Website-Zusammenfassung. Quelle
- [4]Google Search Central, Stand August 2026: Structured Data Guidelines, Dokumentation zu Google-Extended und die offizielle Aussage zu den KI-Funktionen der Suche. Quelle
- [5]Perplexity, Stand August 2026: PerplexityBot Dokumentation, Crawler-Verhalten und robots.txt-Unterstützung.
- [6]Cloudflare, 1. Juli 2025: Cloudflare blockiert KI-Crawler bei neu angemeldeten Domains standardmäßig und fragt beim Setup ab, welche KI-Bots erlaubt sein sollen. Deshalb kann eine Website KI-Crawler aussperren, ohne dass jemand im Unternehmen das entschieden hat. Quelle
- [7]Web.dev, Stand August 2026: Core Web Vitals, LCP, CLS, INP und TTFB Schwellenwerte und Optimierungsstrategien. Quelle
Weiterführende Guides
Grundlagen
KI-Sichtbarkeit: Der komplette Guide
Was KI-Sichtbarkeit bedeutet, warum sie entscheidend ist und wie du sie erreichst.
ChatGPT
Sichtbarkeit in ChatGPT
Wie du in ChatGPT-Antworten erscheinst und was OpenAI als Quelle bevorzugt.
Perplexity
Sichtbarkeit in Perplexity
Der schnellste Kanal für KI-Sichtbarkeit. Taktiken und Messung.
Vergleich
SEO vs. AI SEO
Die Unterschiede zwischen klassischem SEO und KI-Optimierung.
Ist deine Website KI-ready?
Finde heraus, ob KI-Crawler deine Website lesen können, oder ob du unbewusst blockierst. Kostenlose technische Kurzanalyse in 48 Stunden.
Kostenlose KI-Analyse anfragen